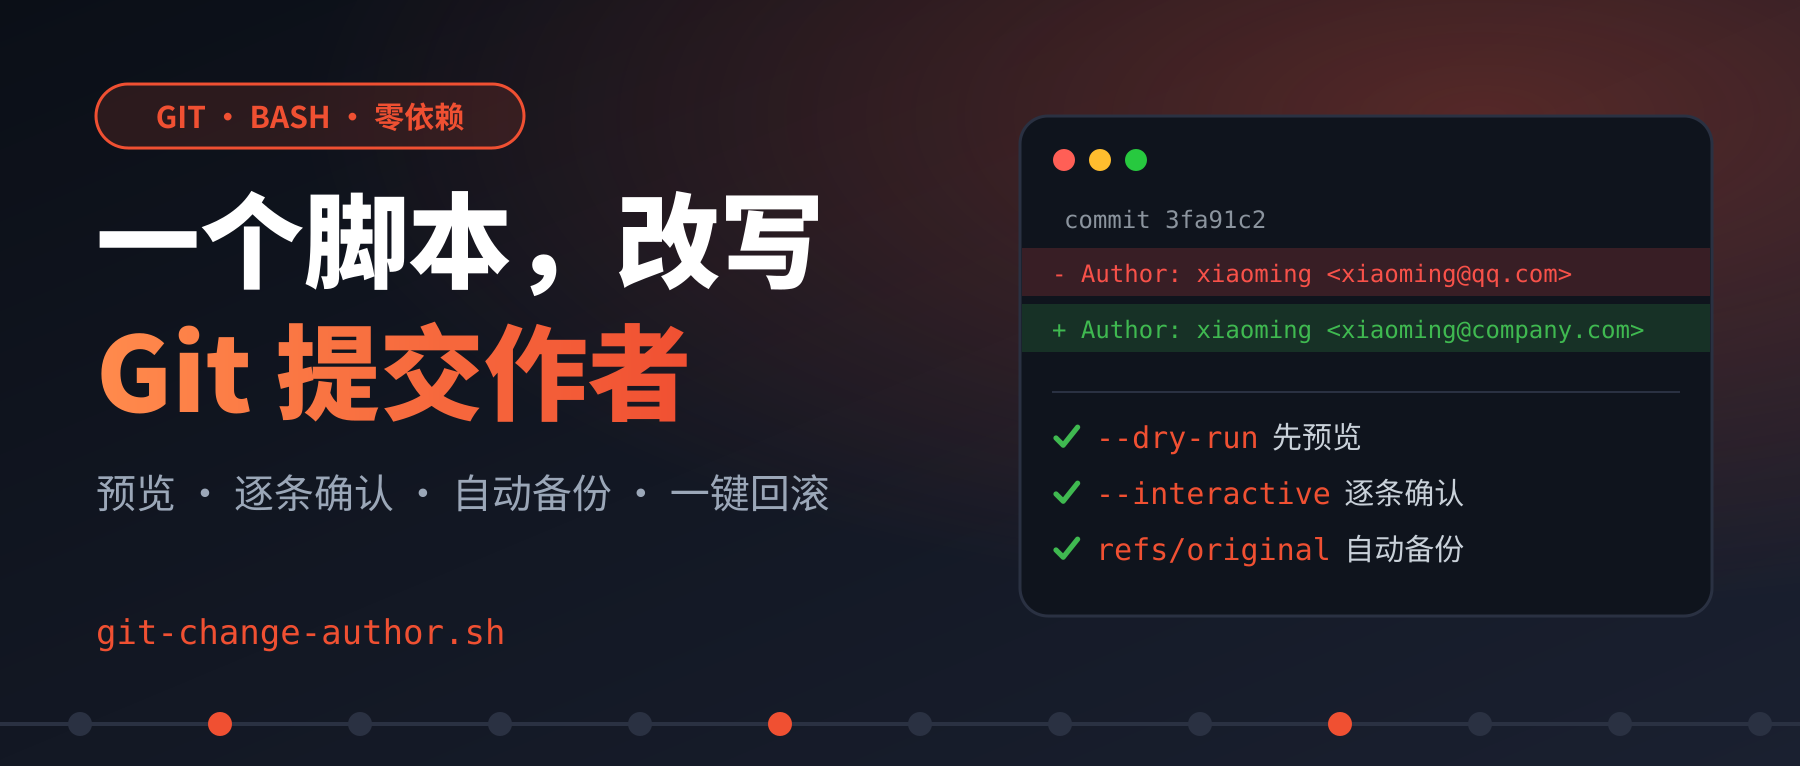
Git 提交署错名字别硬改了!dry-run 预览 + 逐条确认 + 自动备份,一条命令搞定
Git 提交署错名字别硬改了!dry-run 预览 + 逐条确认 + 自动备份,一条命令搞定周五下午,你刚把项目推上公司仓库,同事路过瞄了一眼 git log:"哎,你这提交怎么都是 xiaoming@qq.com?"你低头一看,心里咯噔一下——新电脑没配全局邮箱,过去三个月的提
寻门而入,破门而出




Git 提交署错名字别硬改了!dry-run 预览 + 逐条确认 + 自动备份,一条命令搞定周五下午,你刚把项目推上公司仓库,同事路过瞄了一眼 git log:"哎,你这提交怎么都是 xiaoming@qq.com?"你低头一看,心里咯噔一下——新电脑没配全局邮箱,过去三个月的提
家里的电表早已联网,但 Home Assistant 里一直看不到电费。每次想知道本月用了多少电、账户还有多少钱,都得单独打开“网上国网”查一遍。前段时间我把这个缺口补上了。现在余额、本月电费、历史欠费、日用电量、月度账单都在同一个 HA 看板里。安装本身不复杂,真正花时间的是后来发现的自动刷新问题
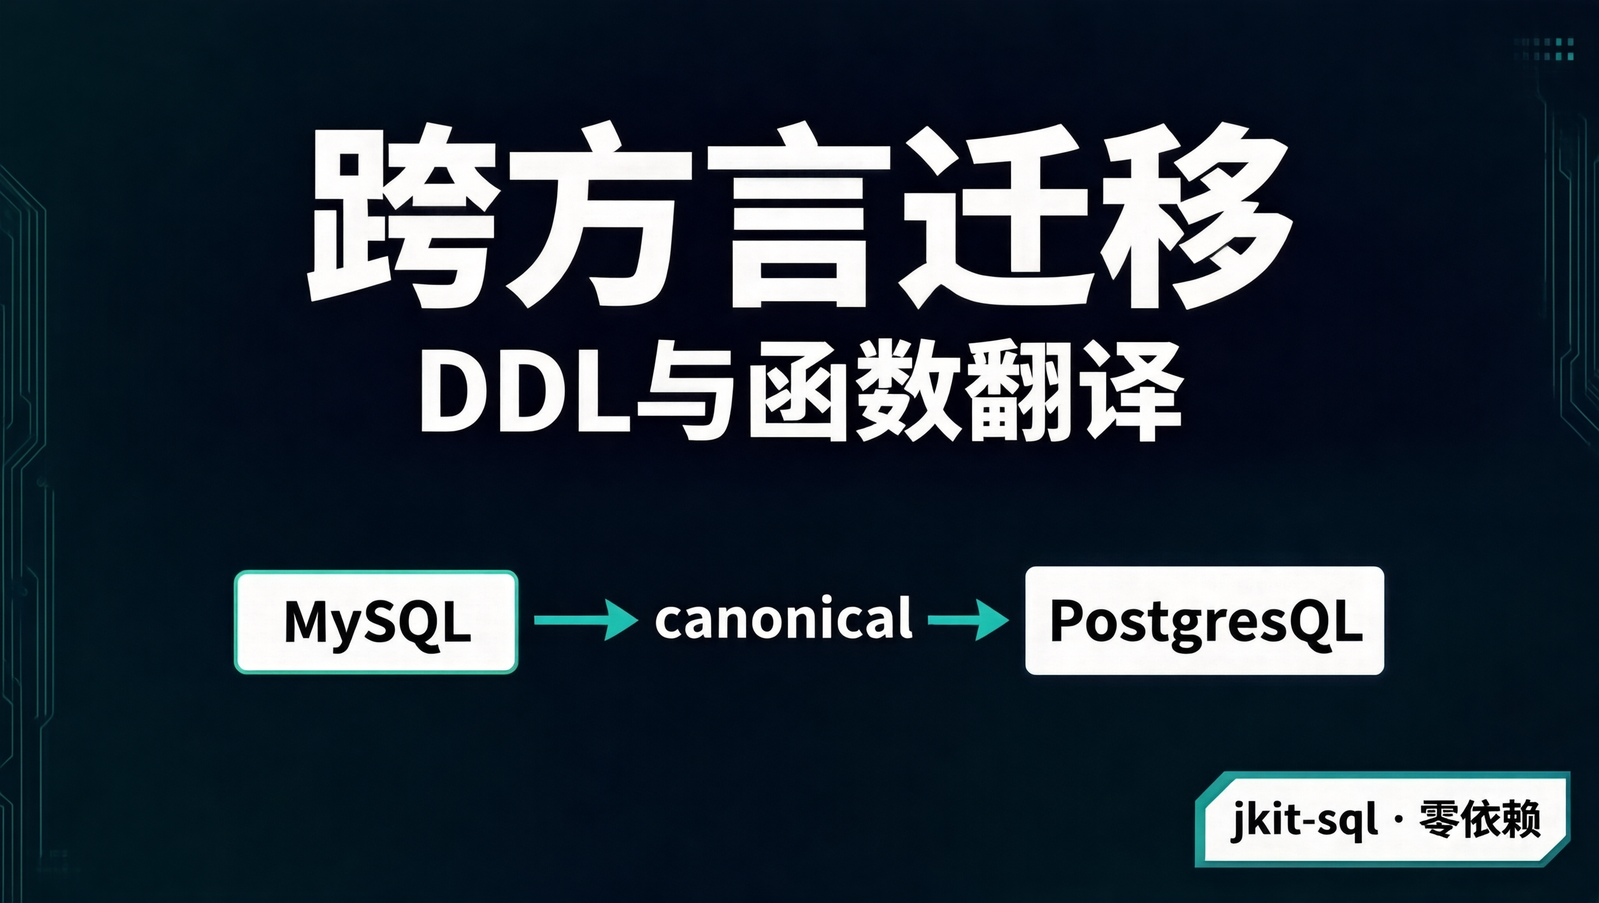
迁库最磨人的不是搬数据,是方言怎么转换信创、降本、换 PG,数据库迁移已经不稀奇了。数据搬过去往往有现成工具;真正耗人的是 SQL / DDL 文本层——类型、自增、函数名、标识符引号,每种库写法都不一样。几百张表靠手改,改完还不敢保证目标库能跑:验证成本常常比改写还高。jkit-sql 做的是把这
1200 条复杂 SQL,4 大数据库通吃:一套能直接跑的业务分析语料库电商 / 金融 / 人力,50 张真实表 + 约 8 万行数据,导入即跑,拿走不谢。做数据分析、写 SQL 的同学,多少都经历过这个瞬间——收藏夹里躺着一堆「SQL 面试题」「窗口函数大全」「100 个必会查询」,真到了业务里要

做 Java 爬虫或自动化测试,定位元素是基本功。今天聊聊 jvppeteer 里那些好用到飞起的选择器 API。做前端自动化或者写爬虫的朋友,对 Puppeteer 一定不陌生。但如果你的项目是 Java 技术栈,Node.js 那套用不上怎么办?jvppeteer 就是答案——它是 Puppet
Java 程序员的浏览器自动化利器:Jvppeteer 从入门到实战先说个事实:在浏览器自动化这个领域,Node.js 的 Puppeteer 已经统治了好几年。Python 有 Playwright 做替代,Go 有 chromedp,唯独 Java 这边一直缺一个"用起来顺手"
AI 写的代码,单元测试到底该怎么写?聊个最近让我挺纠结的事。自从 Copilot、Cursor 这些东西铺开之后,我身边写代码的朋友明显分成了两派。一派是"AI 写完我就提 PR",另一派是"AI 写完我还得自己过一遍才敢合"。而让我纠结的,是夹在中间的那件
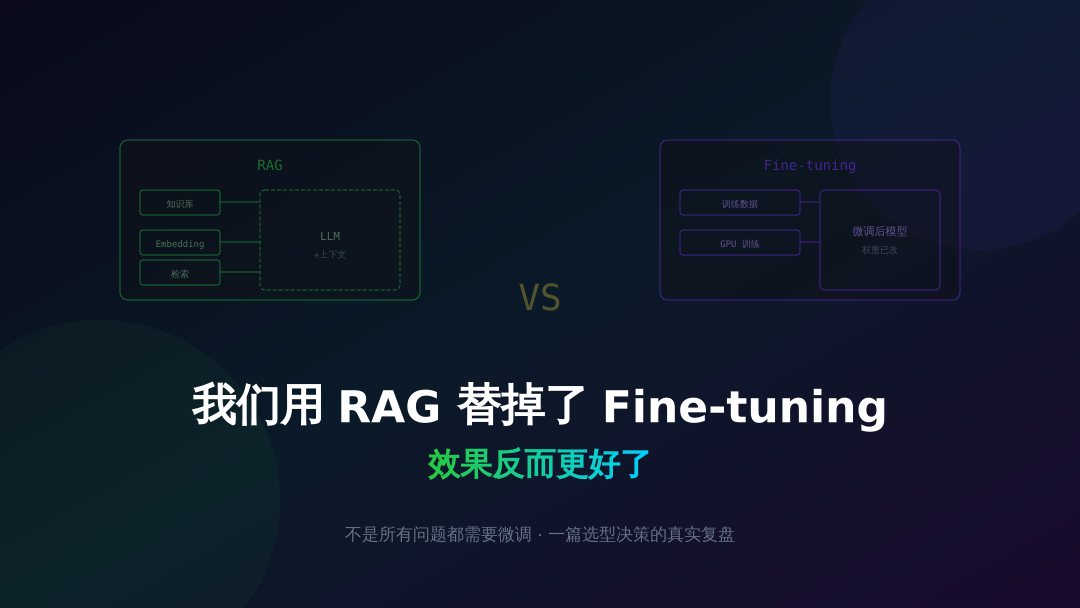
我们用 RAG 替掉了 Fine-tuning,效果反而更好了不是所有问题都需要微调。这是一篇选型决策的真实复盘,聊聊我们团队踩过的坑和最后的结论。先说结论我们花了大概四周时间和四万块的 GPU 费用,证明了一件事:我们的场景不需要 Fine-tuning。这听起来像一个很蠢的故事。但我觉得很多团队
最烦那种"我用 AI 三分钟搞定"的推文AI 确实能提效,但三分钟搞定的不是你的代码,是你的智商税。打开 Twitter 就想关掉每隔几天,我的 timeline 上就会出现一条类似这样的推文:"以前写这个要两天,现在用 Claude/GPT/Copilot 三分钟搞定
你真的需要本地跑大模型吗?不卖课、不贩卖焦虑、不搞成功学。Ollama 火了之后,好像每个开发者都在本地跑模型。但说实话,大部分人的使用场景根本不需要本地部署。这篇聊聊什么时候本地有意义,什么时候纯属浪费时间。跟风的代价我身边至少有五六个朋友,装了 Ollama,下了好几个模型,跑了一下"
Hi,Friend