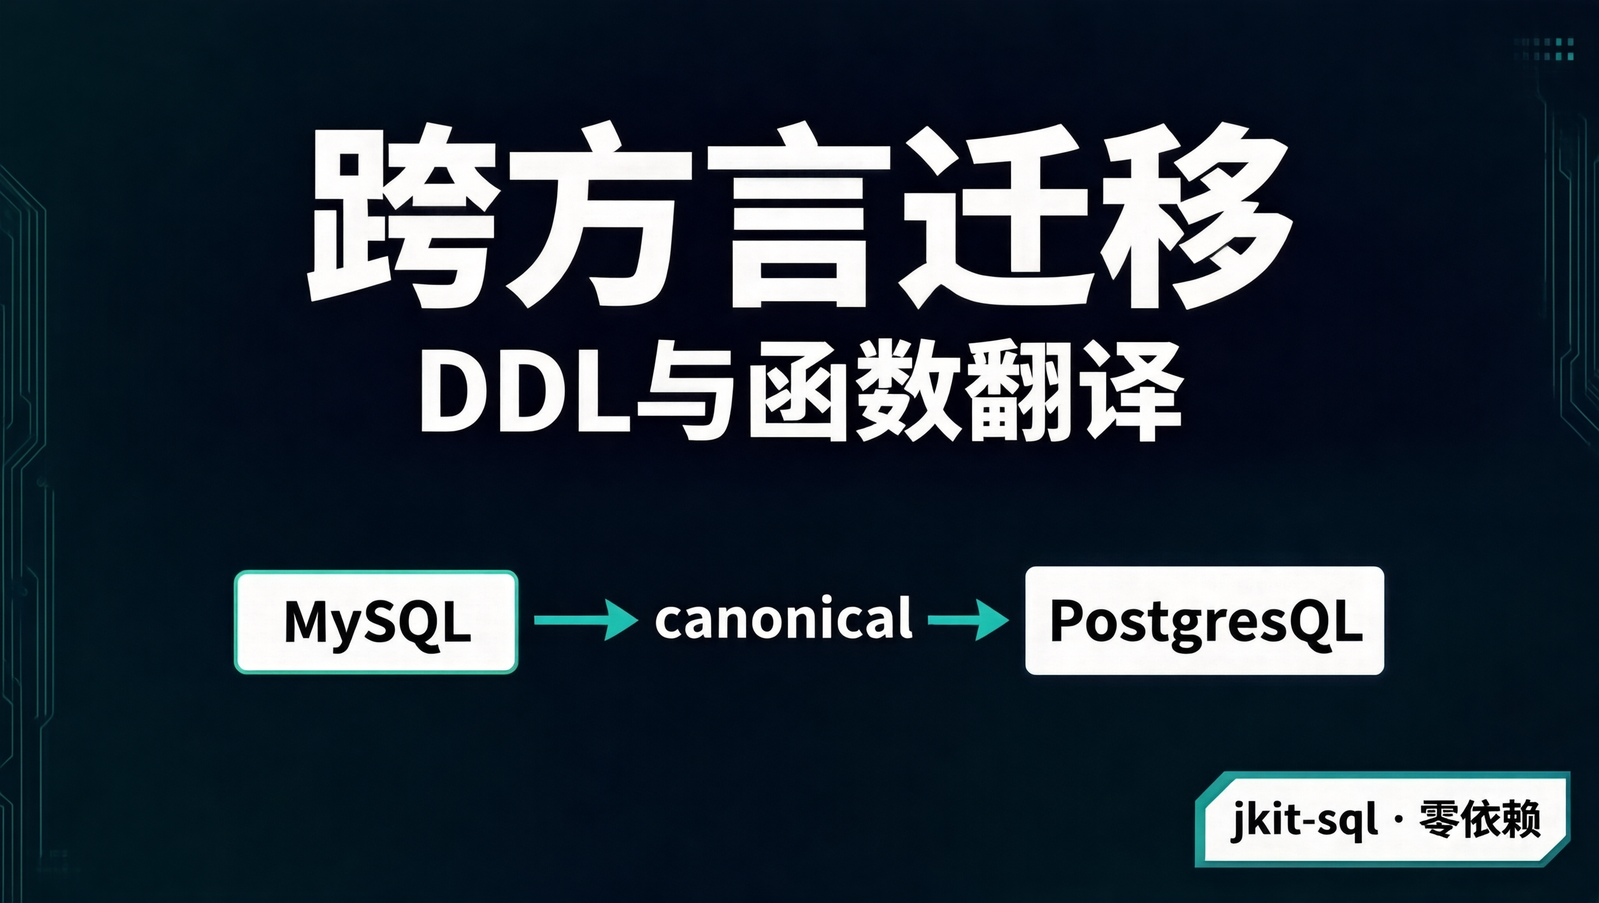
迁库最磨人的不是搬数据,是方言怎么转换
迁库最磨人的不是搬数据,是方言怎么转换信创、降本、换 PG,数据库迁移已经不稀奇了。数据搬过去往往有现成工具;真正耗人的是 SQL / DDL 文本层——类型、自增、函数名、标识符引号,每种库写法都不一样。几百张表靠手改,改完还不敢保证目标库能跑:验证成本常常比改写还高。jkit-sql 做的是把这
寻门而入,破门而出




迁库最磨人的不是搬数据,是方言怎么转换信创、降本、换 PG,数据库迁移已经不稀奇了。数据搬过去往往有现成工具;真正耗人的是 SQL / DDL 文本层——类型、自增、函数名、标识符引号,每种库写法都不一样。几百张表靠手改,改完还不敢保证目标库能跑:验证成本常常比改写还高。jkit-sql 做的是把这
对外接口自动裁掉敏感字段:聊聊列级权限与脱敏数据合规(个保法、GDPR)时代,"谁能看哪些列"是硬需求。但脱敏代码往往散落在每个接口里:if (role == ADMIN) ... else mask(...)。这一篇讲怎么用 AST 改写,在不改业务 SQL、不污染原句的前提下
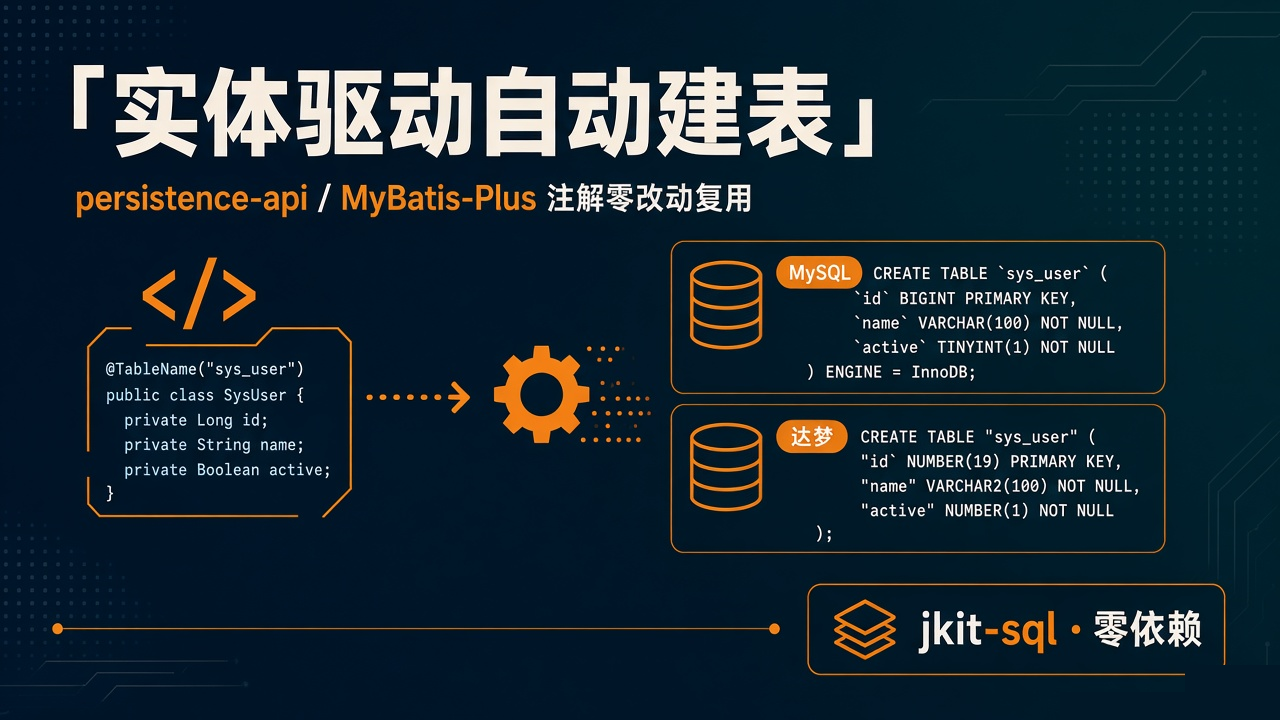
启动服务时按实体自动建表,注解零改动复用实体驱动建表听起来不新鲜——Hibernate 的 ddl-auto、不少脚手架都能干。真正卡住的人,多半不是"会不会生成 CREATE TABLE",而是:项目根本不在 Hibernate / JPA Provider 体系里,却已经有一
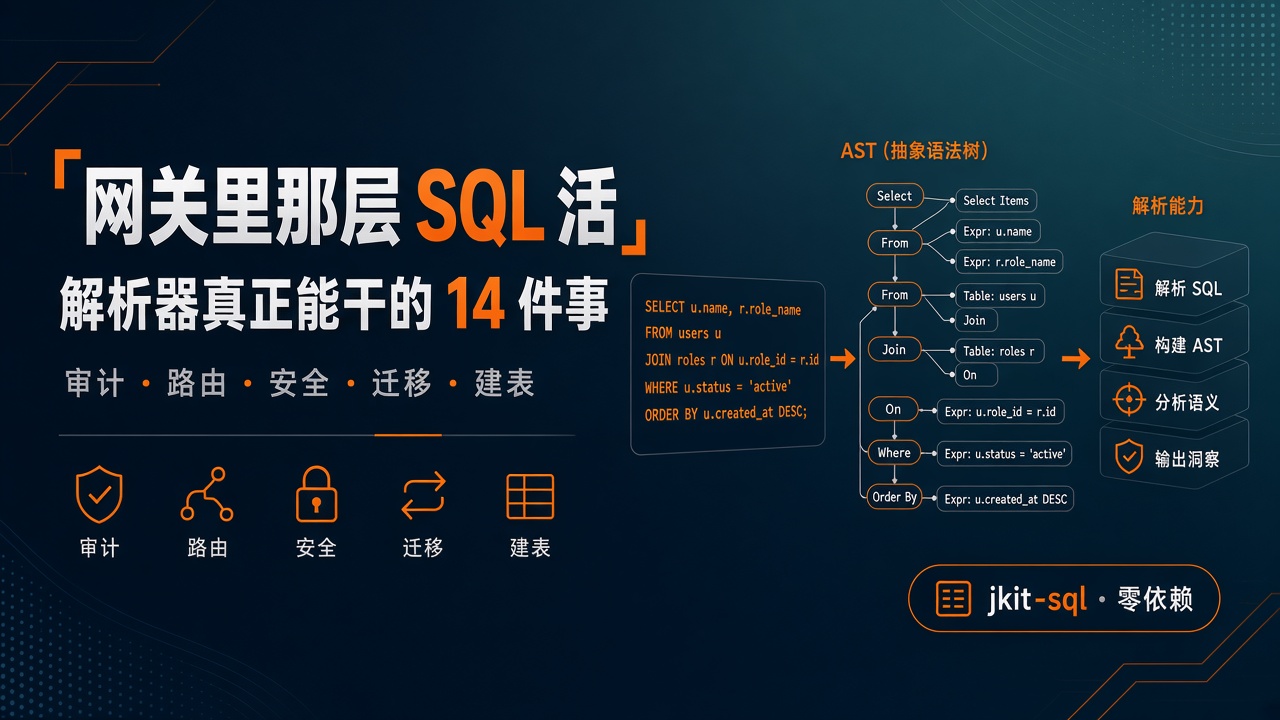
14 个业务场景,一个 SQL 解析器全干完标题里写「网关」,是因为审计、路由、Wall、租户改写最常落在这一层;但同一套能力也覆盖迁移、分页、实体建表、格式化、遗留模板——凡是要读懂、改写、校验 SQL 文本的地方都用得上。真正卡住的往往不是「能不能执行 SQL」,而是「能不能处理别人给过来的 S
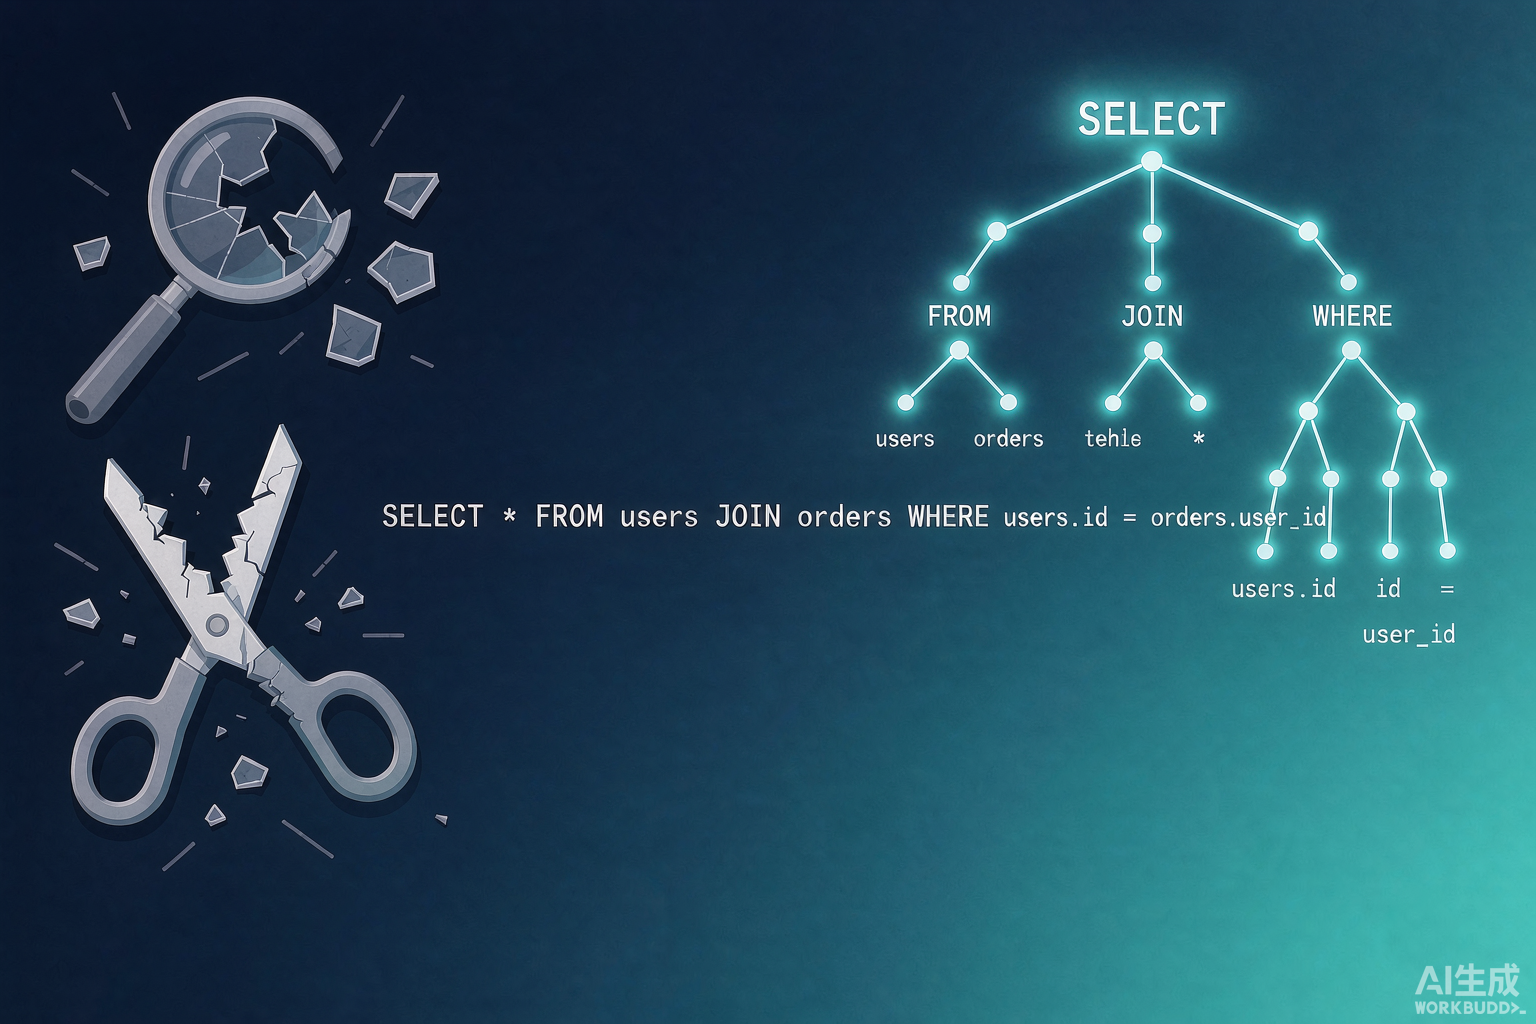
SQL 不是字符串:一个零依赖解析器能替你干的六件事SQL 不是字符串:一个零依赖解析器能替你干的六件事一、五分钟写出来的代码需求很朴素:发布前扫一遍订单模块的所有 SQL,列出它们碰了哪些表,评估改动影响面。第一版实现长这样:Pattern p = Pattern.compile("(?
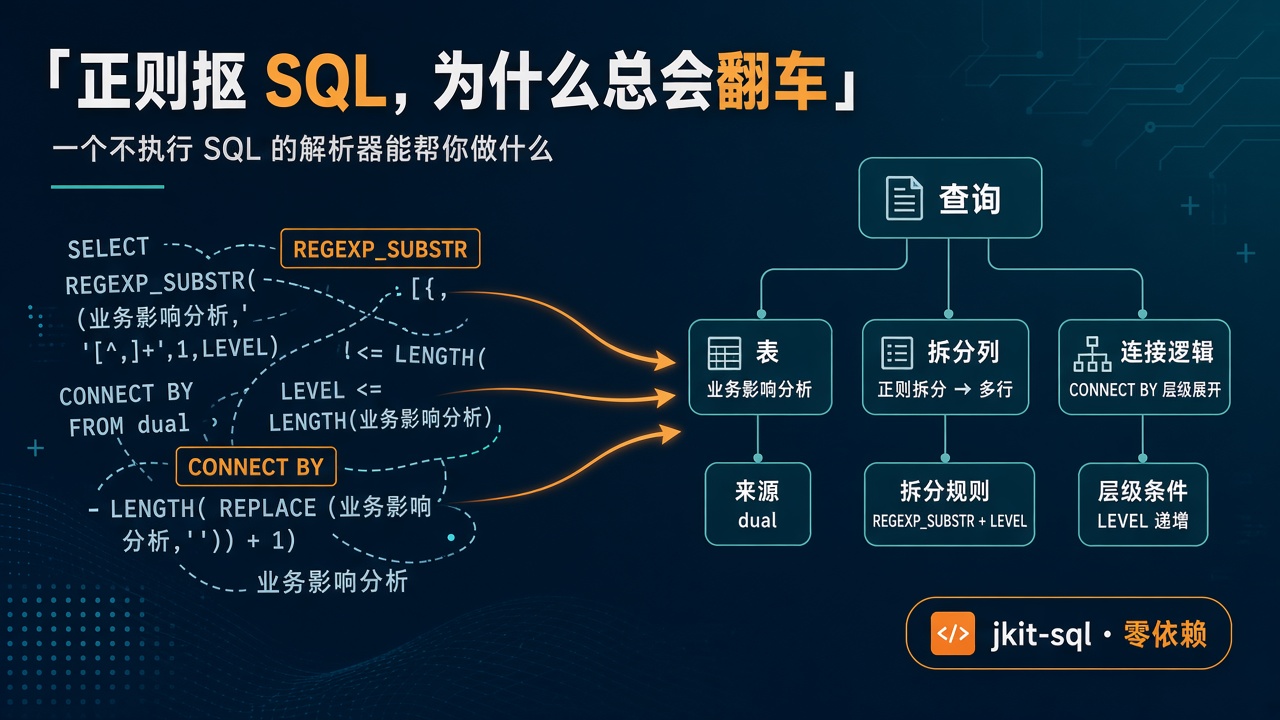
正则抠 SQL 翻车之后:聊聊解析器这件事做过 SQL 审计或上线影响面评估的,大概都试过一招:正则抠 FROM / JOIN。Pattern p = Pattern.compile("(?i)(?:from|join)\\s+([a-zA-Z0-9_`.]+)");Matche
告别繁琐的工具切换:我写了一款 IDEA 插件 DeployX,实现“备份-增量同步-解压-重启”一气呵成作为一名日常与服务器打交道的开发者,你是否也曾被繁琐的部署流程折磨过?在写完代码后,为了将更新部署到测试或生产环境,我们通常需要经历以下一连串的操作:打开 SSH 工具(如 XShell、Win

做 Java 爬虫或自动化测试,定位元素是基本功。今天聊聊 jvppeteer 里那些好用到飞起的选择器 API。做前端自动化或者写爬虫的朋友,对 Puppeteer 一定不陌生。但如果你的项目是 Java 技术栈,Node.js 那套用不上怎么办?jvppeteer 就是答案——它是 Puppet
最近发现一个叫 Anyline 的 Java 中间件,主要解决的问题是统一操作各种不同类型的数据源。做开发时,我们通常会用 MyBatis 或 Hibernate 操作固定的数据库(比如 MySQL)。但在做低代码平台、数据中台、灵活查询或者报表工具时,情况就不一样了。用户可能除了原来主流的 Ora
硬核!Spring容器还没启动,怎么偷看 server.port?三种骚操作带你起飞在日常开发中,我们习惯了 @Value 或者 @ConfigurationProperties 来获取配置。但是,你是否遇到过以下极端场景?日志系统初始化:Logback 或 Log4j2 需要在 Spring Co
Hi,Friend