

25 个变更文件,一行 rsync,换来 25 行报错和一句
total size is 0。
这篇讲我是怎么把「增量上线」这件小事,做成一个敢在发布现场直接用的脚本。
先说结论
如果你的上线流程里,还有这样一个环节:
「把这次改动的文件,挑出来,拷到发布目录,目录结构还得一模一样」
那这个环节,大概率正在悄悄坑你。常见的三种死法:
- 漏:25 个文件,手拷漏了第 17 个,线上缺一个类,凌晨被电话叫醒。
- 错:
src/main/resources少建了一层目录,文件躺在了不该躺的地方。 - 脏:想发的是上一个提交,结果工作区里改了一半的文件、没跟踪的临时文件,一起被带上了车。
我把它们一次性解决了,做成了一个脚本:sync-incremental.sh。下面从我踩的第一个坑讲起。
一、一行 rsync,为什么翻车了
上线清单(sync_files.txt)里是 25 个文件的绝对路径,我写了一行最直觉的命令:
rsync -av --files-from=/tmp/sync_files.txt ./ /opt/share/release/20261117/demo-app
结果:
rsync: [sender] link_stat "/opt/demo-app/opt/demo-app/docs/install.md" failed: No such file or directory (2)
...(一共 25 行)
total size is 0  speedup is 0.00
rsync error: some files/attrs were not transferred (code 23)
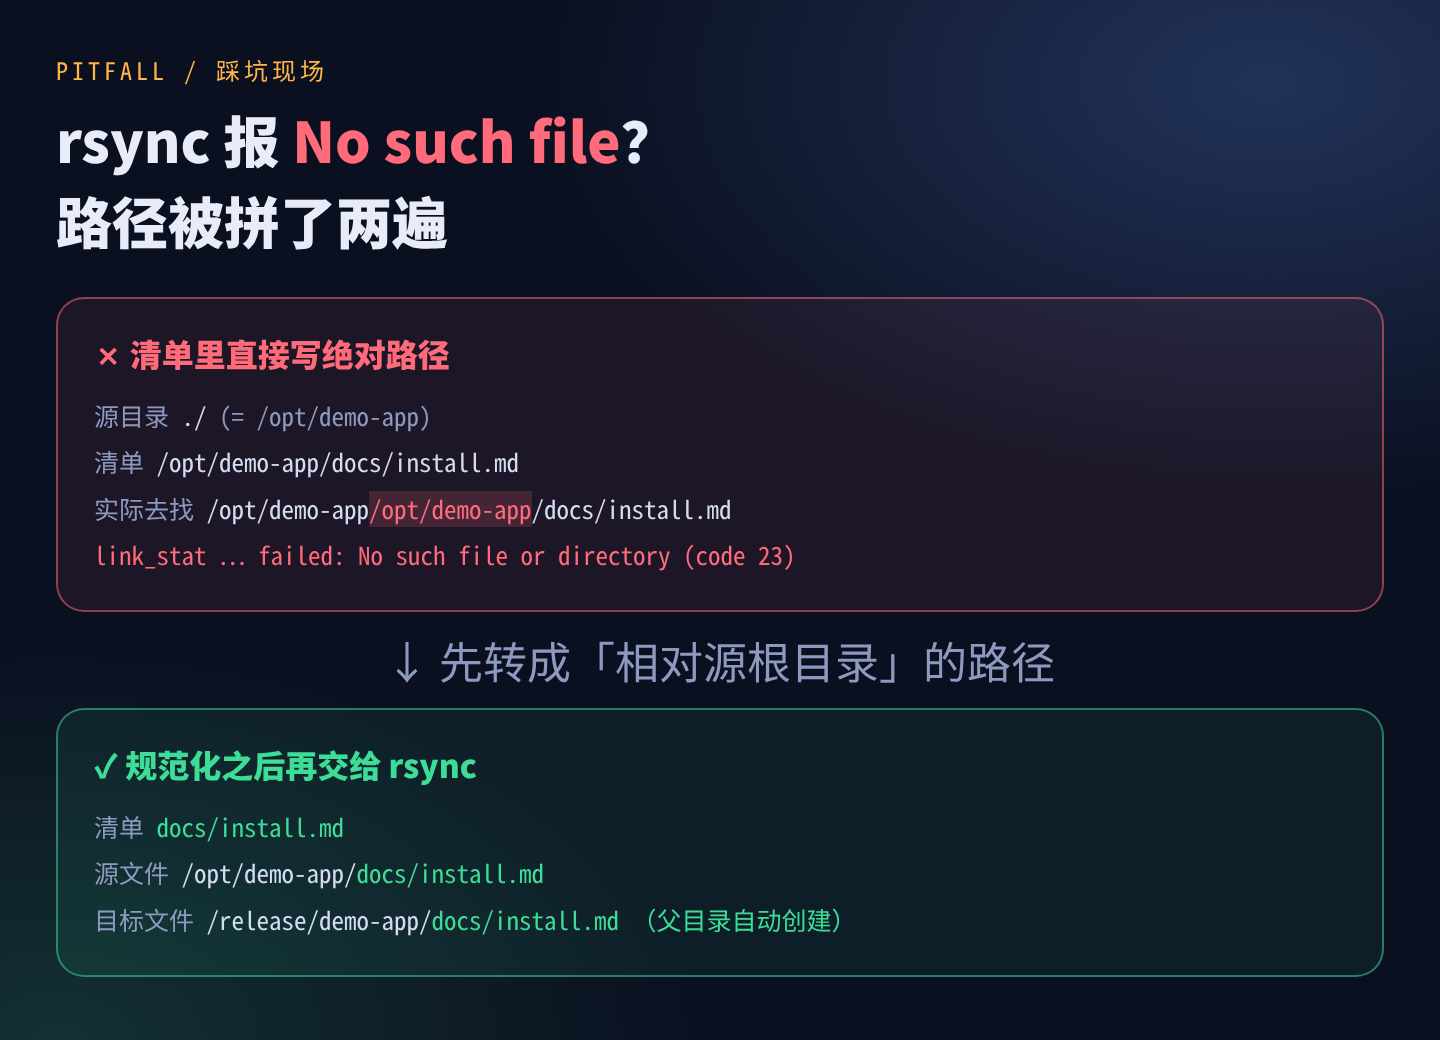
注意看报错里的路径:/opt/demo-app 出现了两遍。
原因很简单,但文档里很容易被忽略:--files-from 里的路径,是相对「源目录」的。你给它绝对路径,它不会当绝对路径用,而是把它拼在源目录后面。
另外还有第二个坑:目标目录的父目录不存在时,rsync 只会帮你建最后一级,上面的多级目录链还得自己 mkdir -p。
这两个问题,单独拿出来都是小事。但上线现场,最怕的就是「小事」。
二、把「手工活」交给流水线
我把整个过程拆成了四步,固定下来:
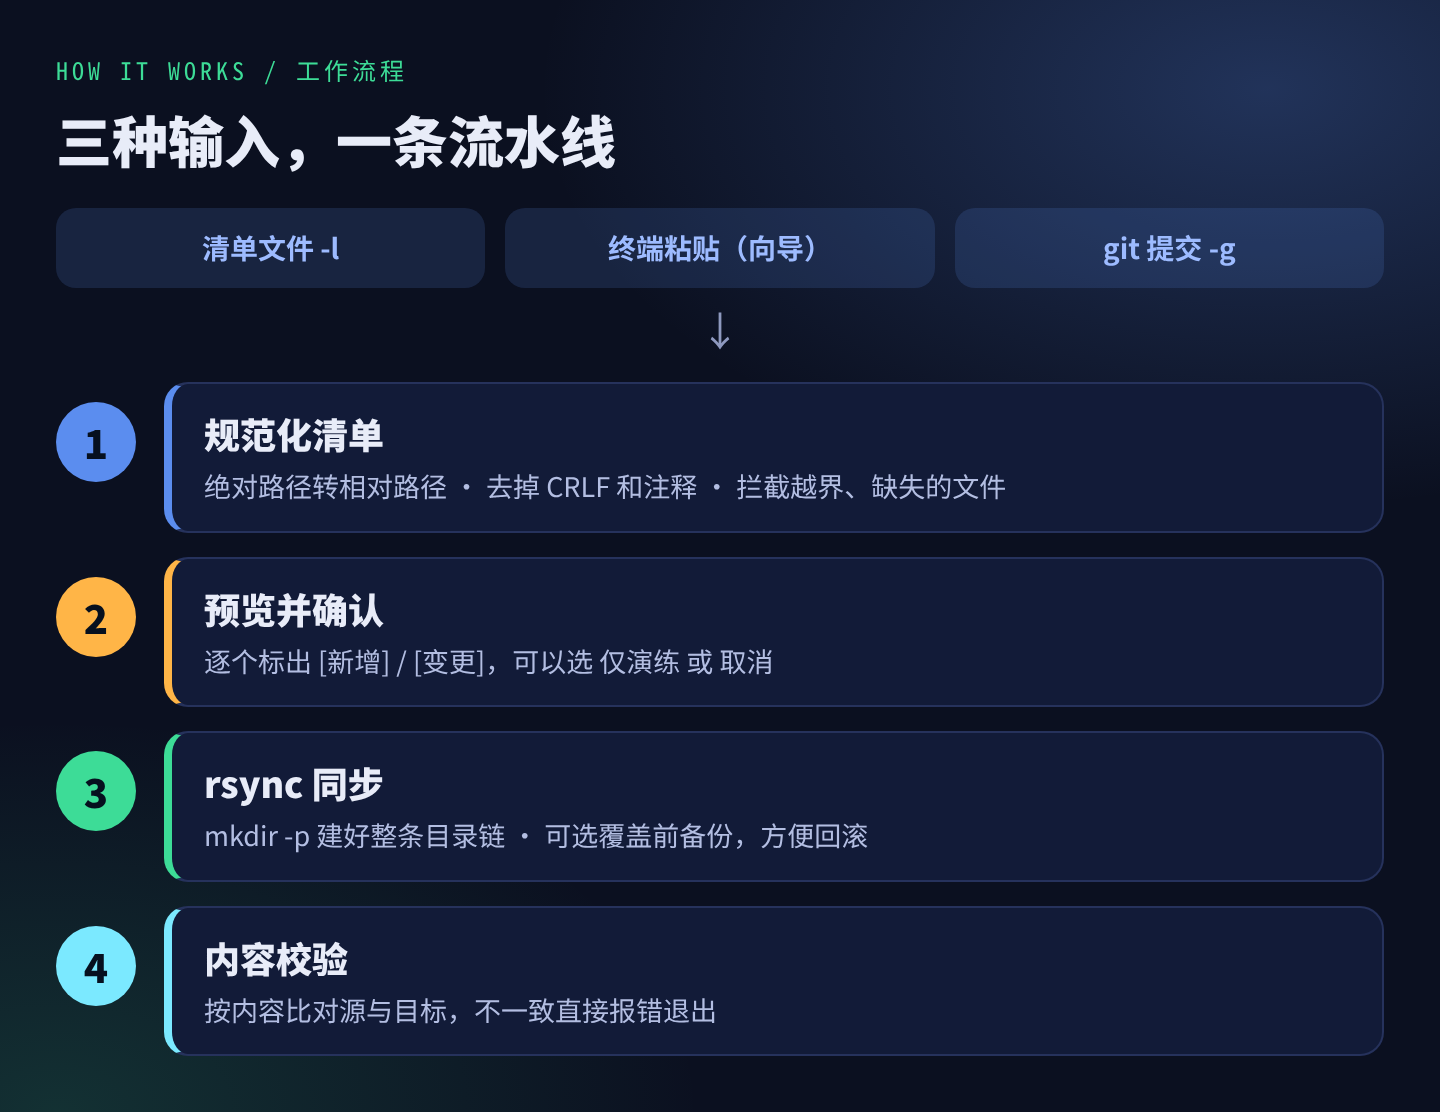
① 规范化清单
绝对路径自动转成「相对源根目录」的路径;去掉空行、# 注释和 Windows 的 CRLF;路径越界(不在源目录下、含 ..)直接拦住;清单里写的文件不存在,默认警告并跳过,加上 --strict 则整体中止,一个文件都不拷。
② 预览并确认
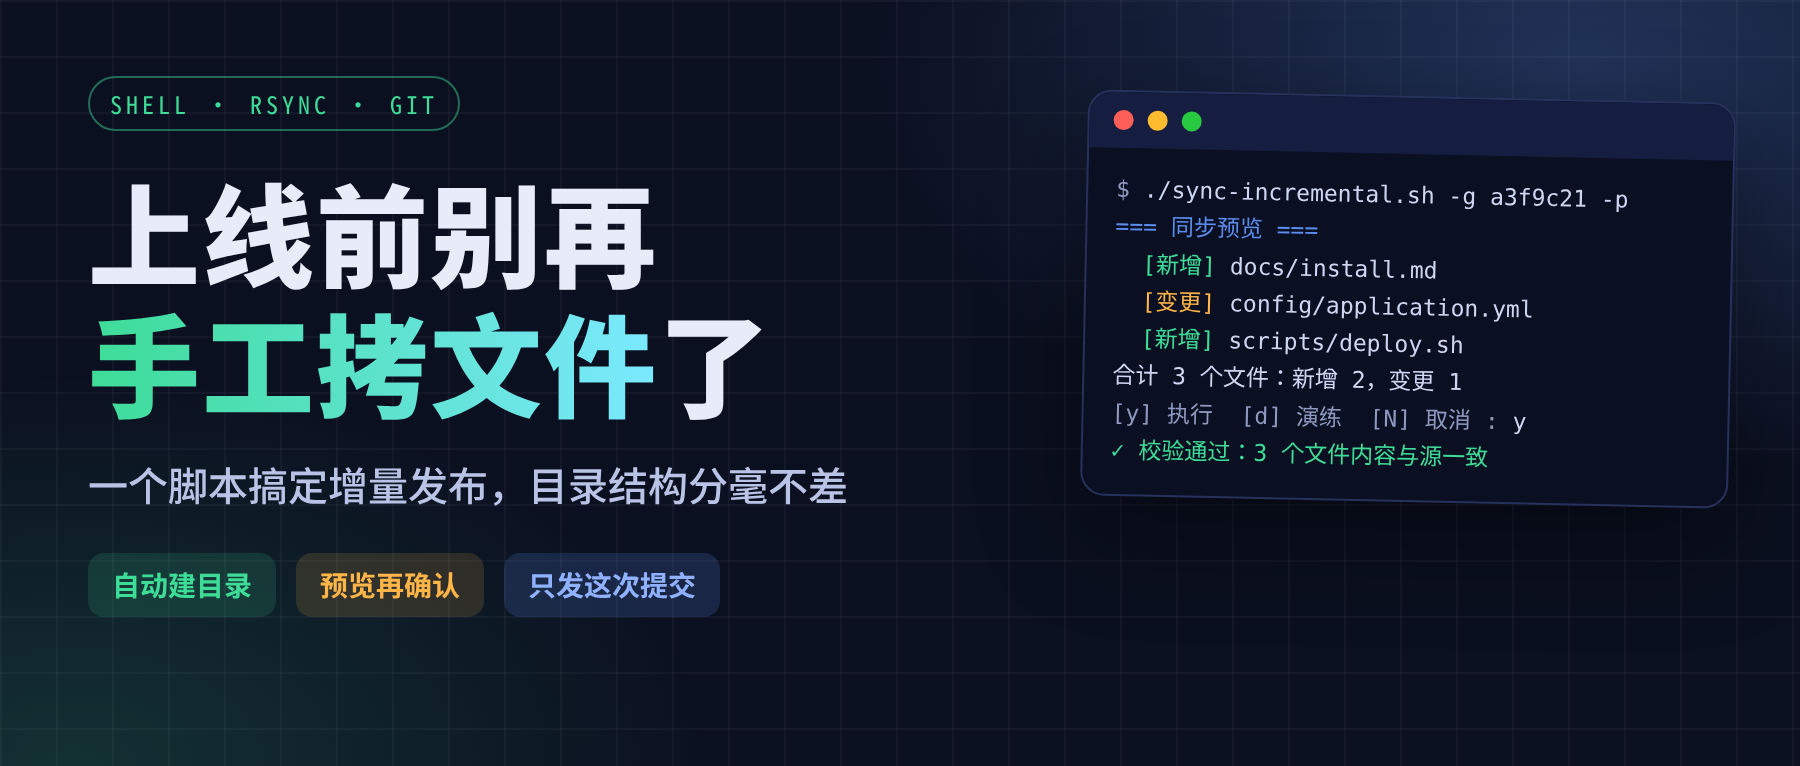
真正拷贝之前,先告诉你每个文件是 [新增] 还是 [变更],再让你选:执行、仅演练、取消。
③ rsync 同步
目标目录不存在就整条链创建;可以开启「覆盖前备份」,把目标端被覆盖的旧文件放进带时间戳的目录,出问题能回滚。
④ 内容校验
拷完按内容比对源和目标,哪怕差一个字节,也会报错退出。
清单怎么来,我留了三个入口:写好的清单文件、在终端里直接粘贴、以及——下面要重点说的——直接从 git 提交生成。
三、最有用的一招:只发「这一个提交」
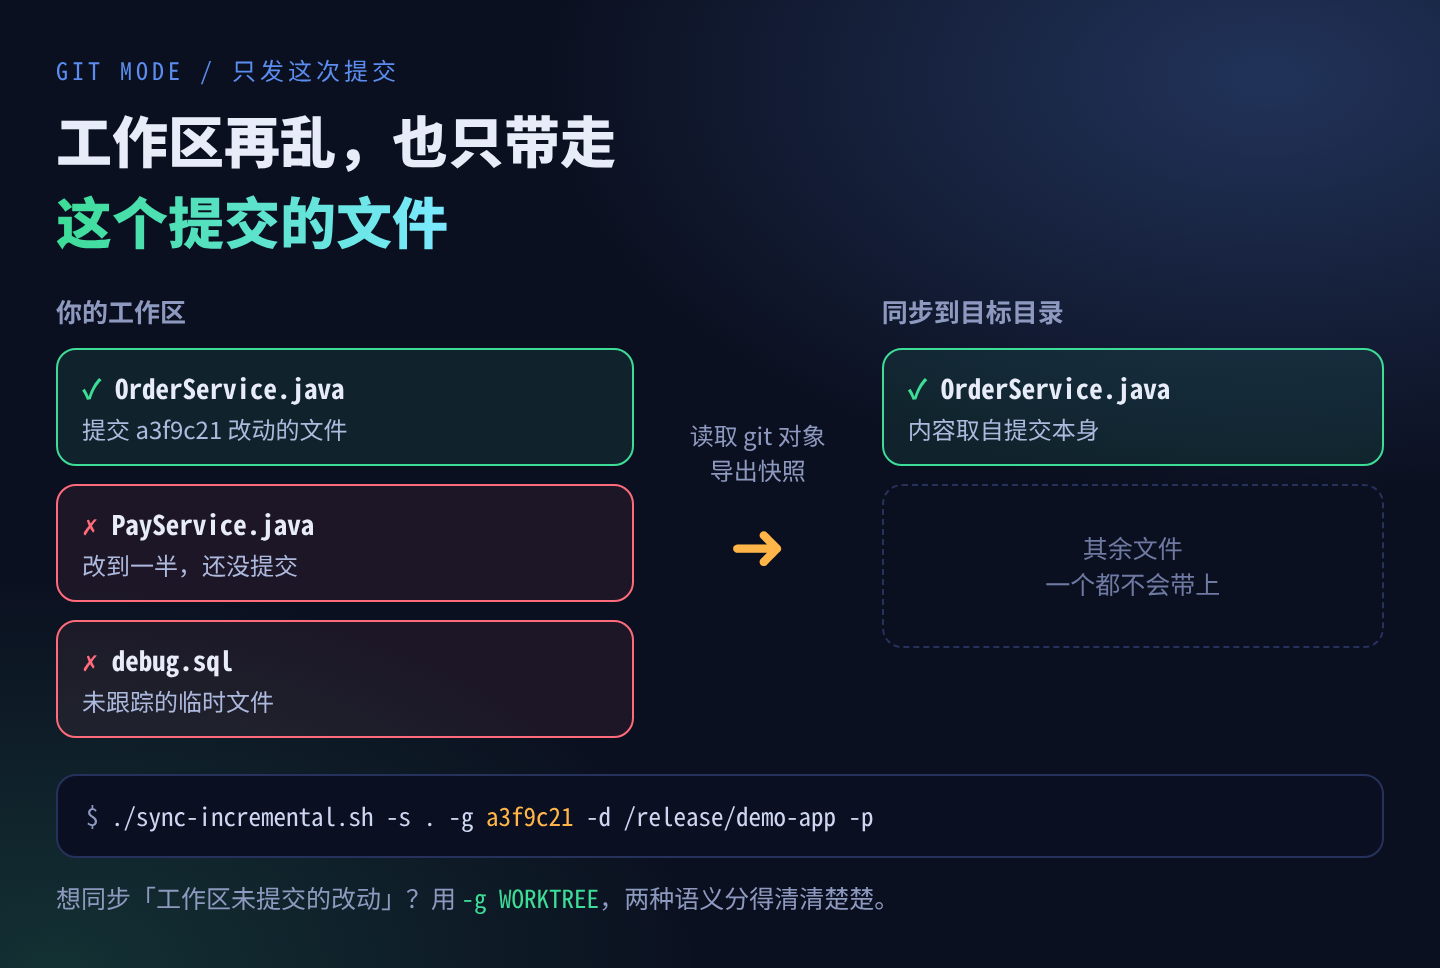
我自己最常遇到的需求是:只把某一个提交改的文件发出去。
脚本最早的 git 模式,用的是 git diff HEAD 加未跟踪文件。后来我发现这是个陷阱:
当你只想发某个提交时,工作区里改了一半的文件、没被忽略的临时文件,会一起被同步过去。
这不是 bug,而是语义没分清:「这个提交改了什么」和「我现在工作区有什么不一样」,本来就是两回事。
所以现在拆开了:
| 写法 | 含义 |
|---|---|
-g <提交哈希> | 只同步该提交自身改动的文件 |
-g "c1,c2,c3" | 多个提交叠加,按提交时间从旧到新,同一文件取最新版本 |
-g A..B | A 到 B 的净变更,内容取自 B |
-g WORKTREE | 工作区未提交变更 + 未忽略的新文件(以前的行为) |
关键在实现:提交模式不读工作区。 脚本会把涉及的文件从 git 对象里导出到一个临时快照,再从快照同步。所以:
- 工作区里你改了一半的文件,不会被带上;
- 工作区里已经有了「后来的改动」,也不会混进来;
- 发出去的内容,和那个提交里的一字不差,评审过什么,就发什么。
被该提交删除的文件,不会被拷贝(脚本只做拷贝,不做删除,目标端不会有文件被它悄悄删掉)。
四、实际用起来是什么样
./sync-incremental.sh -s ~/demo-app -g a3f9c21 \
  -d /release/20261117/demo-app -c -p
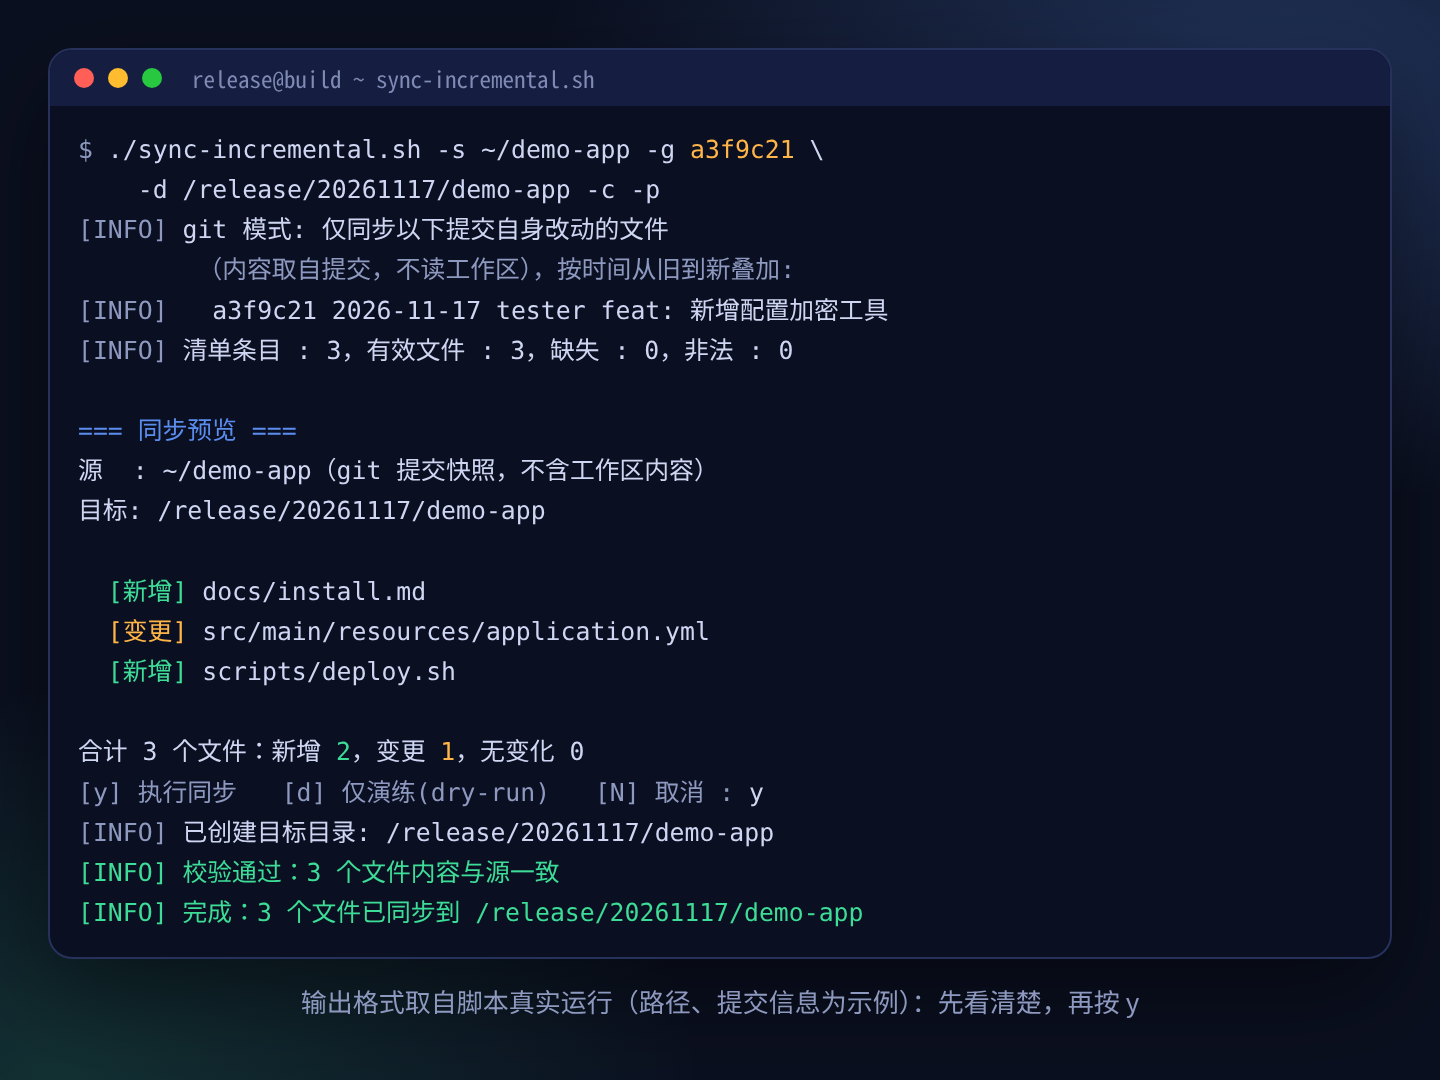
-c 是拷贝后校验,-p 是先预览再确认。先看清楚,再按 y,这个小小的停顿,帮我挡掉过不止一次手滑。
不想记参数?直接在终端里不带参数运行,会进入交互向导:
- 问你源目录;
- 问你清单从哪来(清单文件 / 粘贴 / git 提交,git 模式还会列出最近 10 条提交,输入
#2就选第 2 条); - 问你目标目录(会记住每个源目录最近用过的 5 个目标,输入编号即可);
- 问你要不要校验、备份、严格模式、写日志;
- 跑完后给你一条等效的命令行,下次直接复制。
在 CI 或定时任务里用也没问题:加 -y 跳过确认,退出码区分了参数错误、清单缺失、rsync 失败、校验不一致,方便接到流水线里判断。
五、几个我自己很在意的小细节
- 防误操作:目标目录和源目录是同一个,直接拒绝执行。
- 中文路径没问题:包括目录名、文件名都是中文的情况,输出不会变成一堆转义。
- 可重复执行:没变化的文件不会重复拷,全部已是最新时,预览会直接告诉你「无需同步」。
- 日志落盘:
-L把过程同时写入文件,上线后复盘有据可查。
六、用之前,先看这几条
诚实地说一下它的边界,省得你踩坑:
- 需要 bash 4+ 和 rsync(Linux 开箱即用;macOS 自带的 bash 3.2 不够,需要
brew install bash)。 - 它只拷贝、不删除。被删除的文件需要你自己在目标端处理。
- 不论怎么用,建议第一次先加
-n(仅演练)跑一遍。 - 提交模式直接读取 git 对象,不受
.gitattributes里export-ignore的影响;但 git 子模块会被跳过(只给出警告),需要单独处理。
写在最后
增量上线这件事,技术含量不高,但出错成本很高。好的工具,不是让你更快,而是让你敢慢下来看一眼,然后放心地按下回车。
脚本我已经整理好,开源在 GitHub,欢迎拿去用、提 Issue、顺手点个 Star:
GitHub:https://github.com/zhengmingliang/code-fragment/tree/main/shell/linux/deploy
最后问一个问题:你们团队的增量上线,现在是怎么做的? 手工拷贝、打 patch 包,还是已经全自动了?评论区聊聊,被点赞最多的做法,我下一篇拆开讲。
觉得有用,别忘了 点赞 + 在看 + 转发 给身边还在手工拷文件的同事。
关键词:Shell · rsync · Git · 增量发布 · 运维效率
Q.E.D.