

迁库最磨人的不是搬数据,是方言怎么转换
信创、降本、换 PG,数据库迁移已经不稀奇了。数据搬过去往往有现成工具;真正耗人的是 SQL / DDL 文本层——类型、自增、函数名、标识符引号,每种库写法都不一样。
几百张表靠手改,改完还不敢保证目标库能跑:验证成本常常比改写还高。jkit-sql 做的是把这层翻译自动化,并且用目标方言再 parse 一遍,尽量把语法错提前暴露。
迁移最痛的是方言细节
从 MySQL 迁到 PostgreSQL、达梦或 Oracle,至少会撞上三层差异。
类型。 VARCHAR(100) 到达梦常变成 VARCHAR2;TINYINT(1) 常被当布尔,到 PG 是 BOOLEAN;DATETIME 到 PG 多半是 TIMESTAMP;INT AUTO_INCREMENT 到 PG 是 GENERATED … AS IDENTITY,到经典 Oracle 往往要 SEQUENCE + TRIGGER。
函数。 GROUP_CONCAT → PG 的 STRING_AGG、Oracle 的 LISTAGG;IFNULL → COALESCE / NVL;IF(a,b,c) → CASE WHEN;DATE_ADD → 加减 INTERVAL;NOW() → CURRENT_TIMESTAMP / SYSDATE。
语法。 AUTO_INCREMENT、USING BTREE、反引号标识符、分页形态、注释写法——分页和注释在后续章节单独讲,这篇先盯类型与函数。
手写映射表也能做,但几百张表就是几百个坑;更麻烦的是「改完看起来对,真库一跑才报错」。
别做两两映射
直觉做法是:每对库写一套规则,MySQL→PG、MySQL→Oracle、PG→Oracle……
这样规则数是 N×(N-1)。13 种一等方言就是一百五十多套;每加一种库还要补 2N 套。规则一散,还容易自相矛盾:同一条 TINYINT,有的实现说转 BOOLEAN,有的说转 NUMBER(3)。
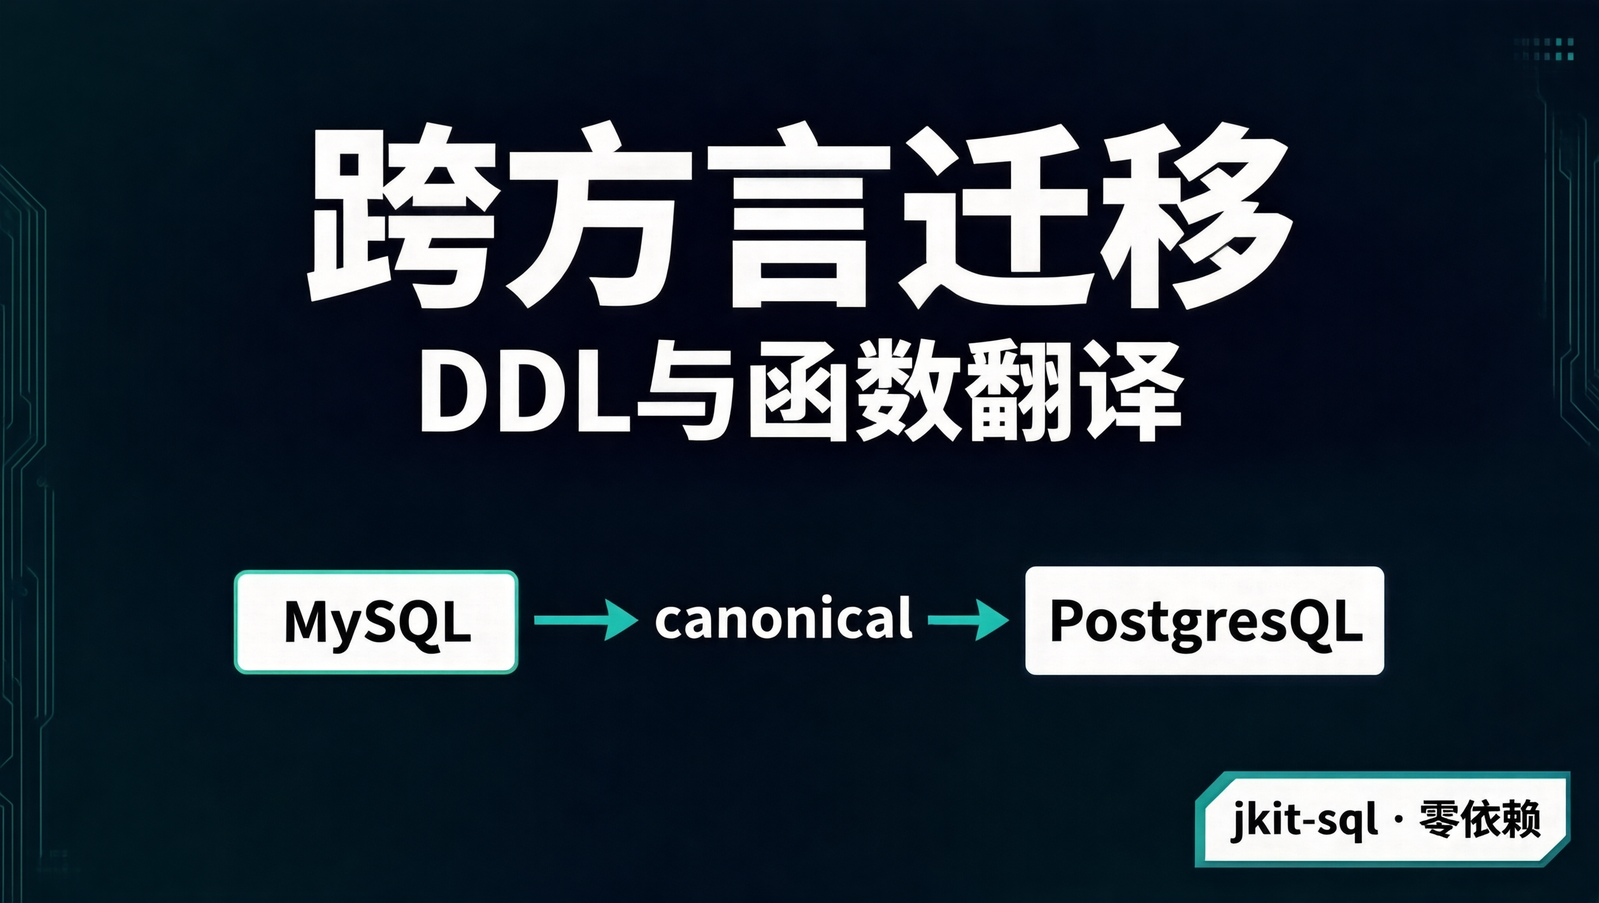
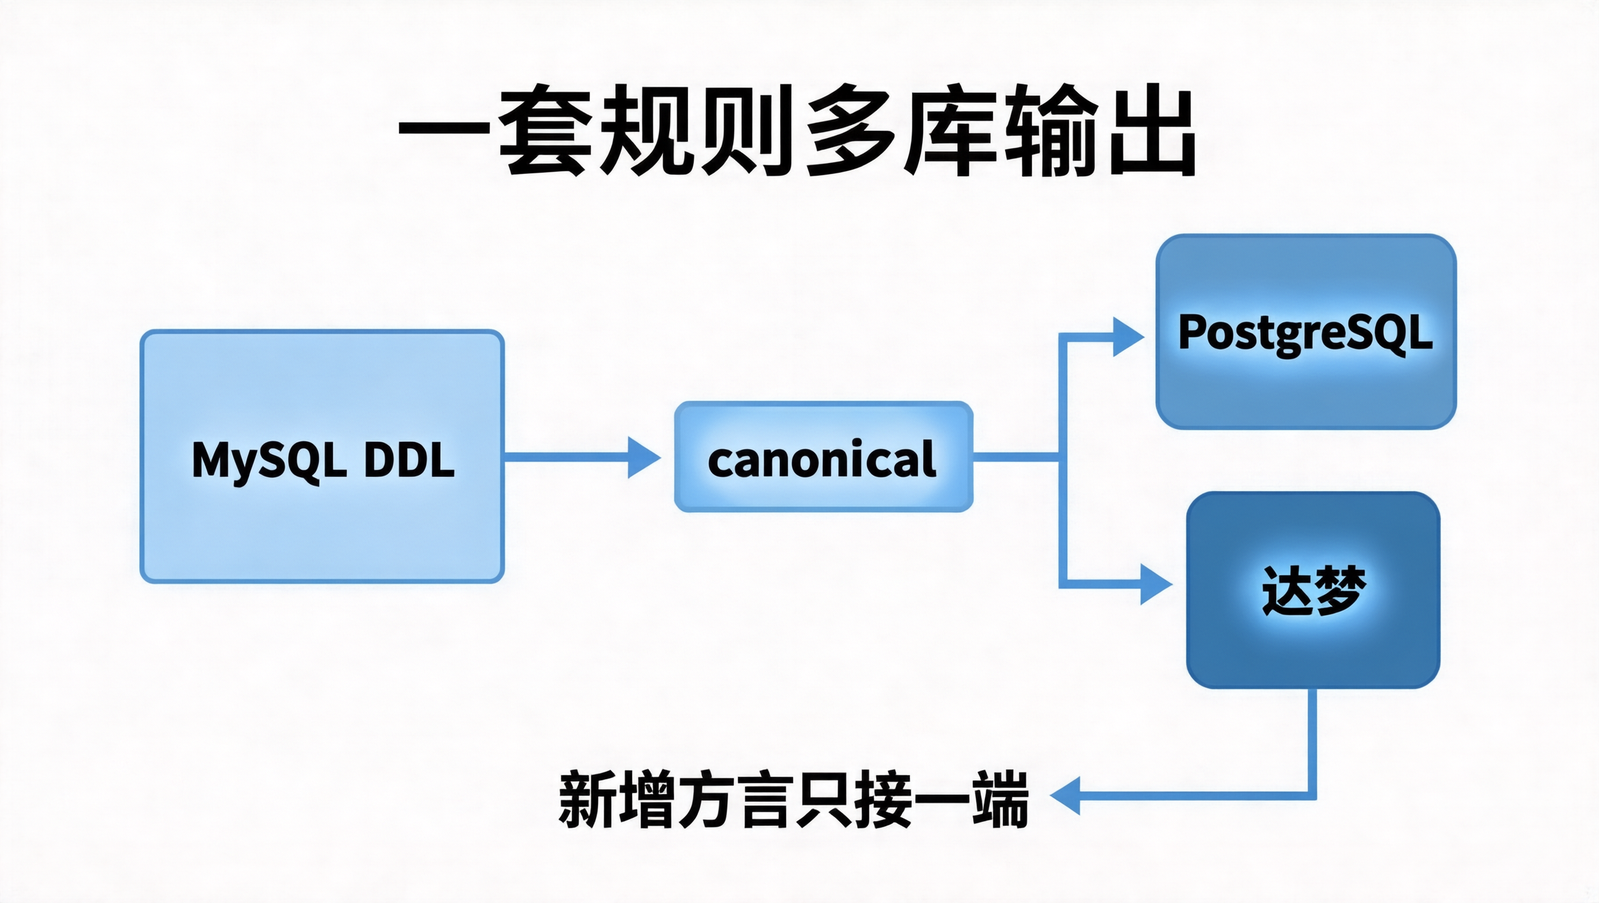
jkit-sql 走 canonical(规范类型)中转:
源方言类型  →  规范类型  →  目标方言类型
TINYINT(1)  →  BOOLEAN   →  PG: BOOLEAN / Oracle: NUMBER(1) / 达梦: NUMBER(1)
先归一,再展开。新增一种库主要是接一端映射,规则量按 N 长,而不是按 N²。同一事实只解释一次,单测也可以拆成「源→规范」和「规范→目标」两段。
convert:一条 DDL 翻过去
import com.alianga.jkit.sql.SQL;
import com.alianga.jkit.sql.SqlDialect;

String pg = SQL.convert(
        "CREATE TABLE t (id INT AUTO_INCREMENT PRIMARY KEY, flag TINYINT(1) DEFAULT 0)",
        SqlDialect.MYSQL, SqlDialect.POSTGRES);
// id INTEGER NOT NULL GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
// flag BOOLEAN DEFAULT false

// 转换结果按目标方言再 parse——解析不过,就当翻译失败
SQL.parse(pg, SqlDialect.POSTGRES);
这句复解析不是摆设。很多脚本输出的是「读起来像目标方言」的文本,只有进真库才露馅;这里在生成阶段就用目标方言解析器自检一遍,方便丢进 CI。
复解析过了也不等于真库一定能跑,后面还得在目标库执行一遍。
批量转换,顺带改函数
import java.util.Arrays;
import java.util.List;
import com.alianga.jkit.sql.schema.convert.ConversionResult;

List<ConversionResult> rs = SQL.convertBatch(
        Arrays.asList(
            "SELECT GROUP_CONCAT(name) FROM t",
            "SELECT IFNULL(a, b) FROM t"),
        SqlDialect.MYSQL, SqlDialect.POSTGRES);
// rs.get(0).sql() → SELECT STRING_AGG(name, ',') FROM t
// rs.get(1).sql() → SELECT COALESCE(a, b) FROM t
已经落地的改写(节选):
IF(a,b,c)→CASE WHEN(非 MySQL)GROUP_CONCAT↔STRING_AGG/LISTAGGIFNULL/NVL/ISNULL按目标方言改名;PG/ANSI 走COALESCECONCAT(a,b,c)到 Oracle 改成a || b || c(Oracle 的CONCAT只接受两个参数)DATE_ADD/DATE_SUB→ 加减INTERVAL;DATEDIFF→ 日期相减;FROM_UNIXTIME→TO_TIMESTAMPDATE_FORMAT:常见格式符会改写到 PG/Oracle 的TO_CHAR或 SQLite 的strftime;对不上的格式符保留并标SEMANTIC_RISKSUBSTRING/LEFT/RIGHT/MID:Oracle/达梦用SUBSTR;SQL Server 两参数补LEN、负起点改RIGHTDECODE/NVL2→CASE;UCASE/LCASE→UPPER/LOWER
Oracle 那条 CONCAT 特别容易漏:同名函数、参数个数不同,手写迁移一疏忽就过不了。
危险转换要亮灯,别静默通过
有些东西目标库没有干净等价物——比如经典 Oracle 的自增、FULLTEXT 索引。jkit 会用 Severity 标出来:
import com.alianga.jkit.sql.schema.convert.ConversionWarning;
import com.alianga.jkit.sql.schema.convert.SqlSchemaConvertOptions;

ConversionResult r = SQL.convert(sql, SqlDialect.MYSQL, SqlDialect.ORACLE,
        SqlSchemaConvertOptions.defaults()
            .failOnSeverity(ConversionWarning.Severity.MANUAL_ACTION_REQUIRED));
// Oracle ≤11g 自增默认 MANUAL_ACTION_REQUIRED;
// generateOracleSequence(true) 会附录 SEQUENCE + TRIGGER
迁移工具最怕的是「生成一段能 parse、语义却偏了」的 SQL。宁可标 MANUAL_ACTION_REQUIRED,也不假装万事大吉。
ConversionResult.sqlWithExtras() 会把附录一起带出(例如独立的 CREATE INDEX、Oracle SEQUENCE),方便整批执行。
一条能落地的工作流
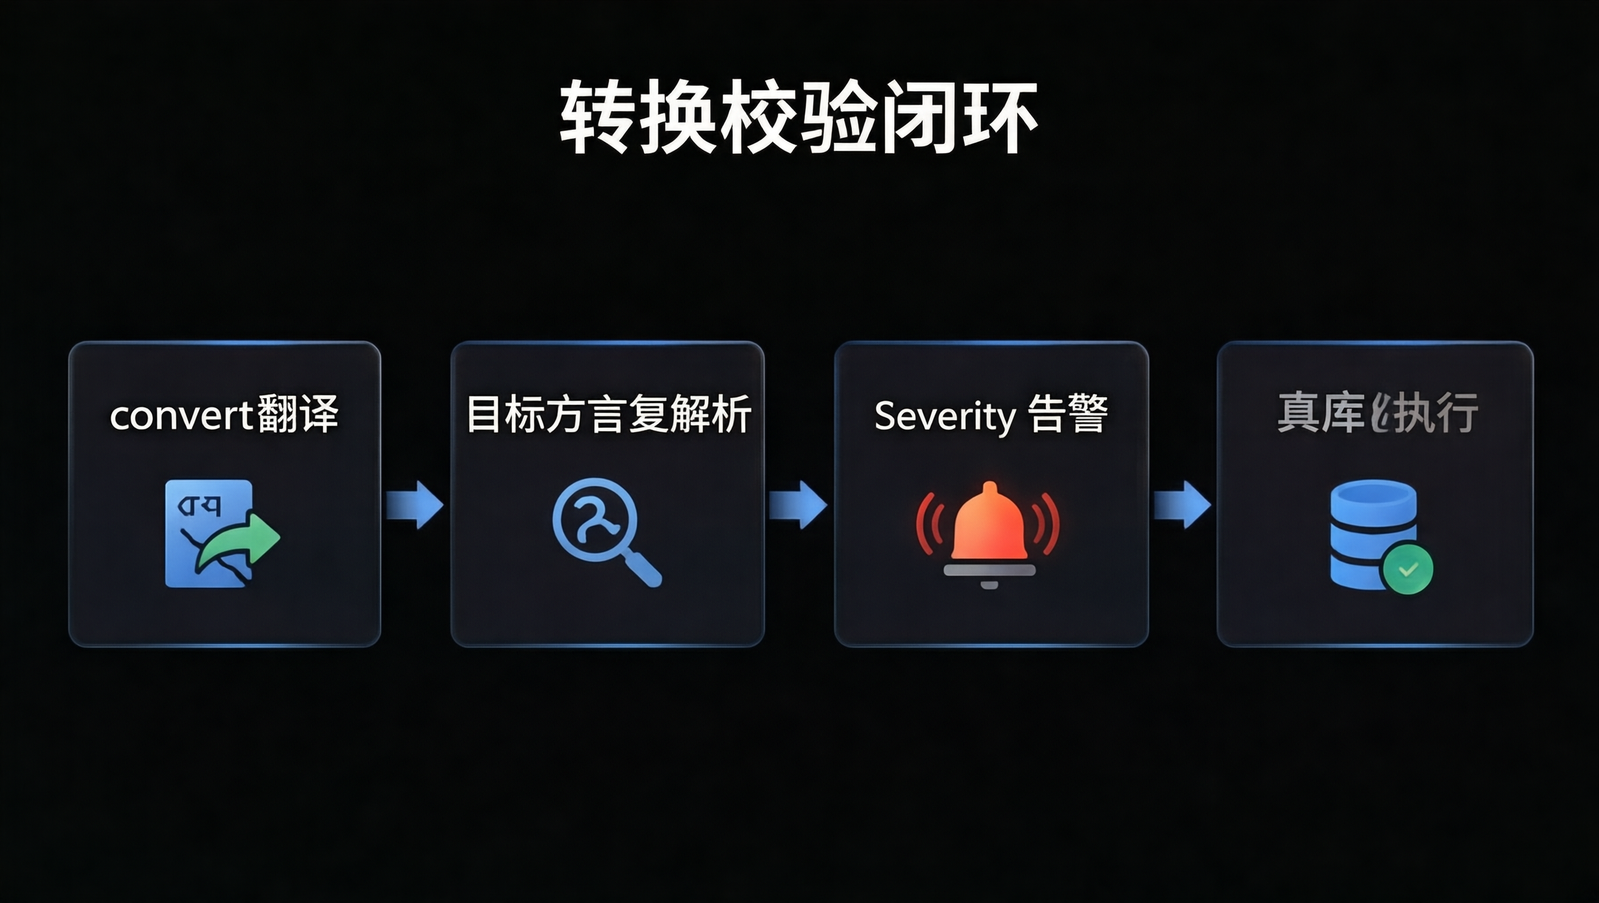
1. 导出:源库 DDL(CREATE TABLE / INDEX / COMMENT)
2. 转换:SQL.convertBatch(ddls, MYSQL, POSTGRES)
3. 复解析:目标方言再 parse(convert 内部已做,也可显式再跑)
4. 看报告:按 Severity 筛出要人工改的条目
5. 真库验证:目标库执行(本地 Docker 起一个 PG 即可)
6. 补例外:MANUAL_ACTION_REQUIRED 手工改
7. 回归:改好的 SQL 进语料,挂进 CI
jkit 自己在 tools-test 里就跑真库闭环,可以直接借用:
cd ../tools-test
mvn -Dtest=CrossDialectDdlExecutionTest test   # MySQL→PG 建表(需 Docker PG,否则 skip)
mvn -Dtest=CrossDialectExprExecutionTest test  # DDL + 表达式真库执行
转换工具只管 SQL 文本层。下面三类别指望它一次搞定:
- 数据本身:字符集、时区、超长字段截断;
- 业务语义:MySQL 非严格模式 vs PG 严格类型,同一条语句一个过一个挂;
- 性能:索引、执行计划、统计信息。
这三类只能在真库上验。
新产品不必改枚举
当前一等方言有 13 个(含达梦、ORACLE12 等)。要接一种新库,不必改 SqlDialect 枚举:实现 SqlDialectSpec(或包一层 SqlDialectWrapper),用 typeFamily() 复用内置类型表,再用 dialectId() + SPI 覆盖个别写法。函数改写也可以通过 SqlSchemaConverterProvider.registerFunctions 追加,不用动内核。
公司里若是冷门国产库,可以先在业务工程里注册方言和几条函数规则,不必等上游发版。
类型映射里四个容易翻车的点
文本层「转换成功」不等于数据层安全。这四个点最常见:
TINYINT(1)。 MySQL 里常当布尔用,类型上却是显示宽度为 1 的 tinyint。转 PG 是 BOOLEAN;转 Oracle / 达梦是 NUMBER(1)(跟 SQL Server 的 BIT 不是一路)。应用若按 true/false 读写,目标库代码可能要跟着改。
无符号整数。 INT UNSIGNED 在 PG / Oracle 没有直接对应。常见做法是升一档(→ BIGINT),否则接近上限的值会溢出。迁之前先查源库有没有顶着上限的数据。
时间类型与时区。 DATETIME(无时区)和 TIMESTAMP(有时区)在 MySQL / PG 语义不一致;Oracle 的 DATE 还带时间。跨时区业务更稳妥的是 TIMESTAMP WITH TIME ZONE——工具只能给默认映射,最终要人拍板。
字符长度单位。 MySQL 的 VARCHAR(100) 是字符数;Oracle 默认常按字节(VARCHAR2(100 BYTE))。中文场景下 100 字节大概只够三十来个汉字,静默截断事故很多都栽在这里。转 Oracle 时要显式 CHAR 语义,或把长度放大。
小结
数据库迁移真正贵的是方言差异,不是「把行拷过去」。canonical 中转把规则量从 N² 压到接近 N;SQL.convert / convertBatch 负责 DDL 与函数翻译,并用目标方言复解析做第一道闸;Severity 把无法自动等价的部分标出来;完整闭环还是导出 → 转换 → 复解析 → 报告 → 真库 → 补例外 → CI。
数据、业务语义、性能这三块,仍要人在真库上盯。
下一篇讲实体到表结构:扫描 persistence-api / MyBatis-Plus / jkit 注解生成多方言 DDL。
文档:https://jkit.alianga.com/
源码:jkit-sql(develop)
Q.E.D.